为了自动爬取某视频网站的迅雷链接,决定研究一下。
首先随意的挑了一个视频查看其源码:
试了一下urllib,结果发现拒绝访问,好吧,还是得修改头文件。
于是,上urllib2。这次成功了。
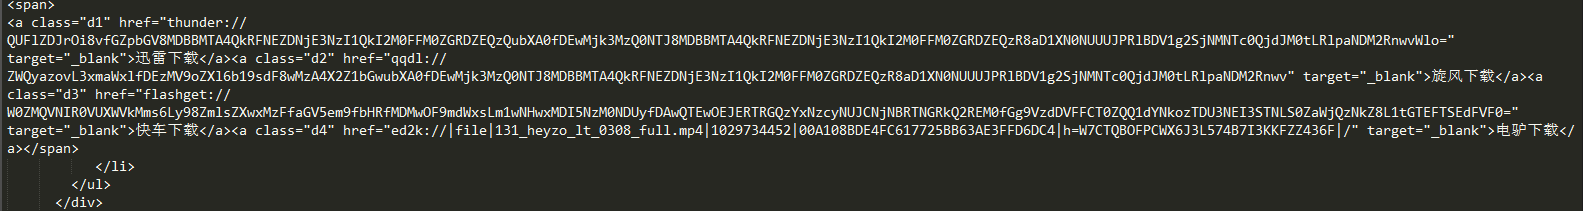
找到这个部分:
看到这个结构就好办了,使用正则表达式匹配:
thunder=re.findall(r’href=”(thunder.*?)”‘,res)
因为其网站的目录结构为://vod/***.html
所以这里以i为变量遍历了该站的视频目录。即访问了(1.html,2.html,3.html……)
然后将视频的标题以及迅雷链接保存进文本。
代码实现如下:
前排提示:header配置已经写入urllib2库中,因此使用时没有再定义header。
#encoding=utf-8
import urllib2
import re
url = ‘https://***********/vod/’
file=open(‘thunder.txt’,’w’)
i=0
while i<10000:
i=i+1
print i
urltemp=url+str(i)+”.html”
f=urllib2.urlopen(urltemp,timeout=5)
res=f.read()
thunder=re.findall(r’href=”(thunder.*?)”‘,res)
if thunder==[]:
continue
title=re.findall(ur'<title>(.*)-‘,res)
file.write(title[0]+”\t”+thunder[0]+”\n”)
print(“finished”)
程序效果如下(放在云服务器上跑了近30个小时才爬完10000个,事实上10000后面还有更多,这里只是做交流学习就没有必要再继续下去了):

如果有出现什么错误或者有疑问欢迎添加为微信公众号或者加入QQ群与我交流。