最近发现项目使用的IP地址解析工具,准确率很低,然后解析出的地址信息是文本,匹配省市县信息还需要复杂的解析,效率效果都很差,于是决定重构这一模块。
查阅了大量网上的方案,商业API的效果很好,但我个人项目使用没有必要,并且要求也没有那么高,还是用开源的吧。
首先我找到了ip2region工具,选择了他的java实现,引入依赖。
<dependency>
    <groupId>org.lionsoul</groupId>
    <artifactId>ip2region</artifactId>
    <version>2.7.0</version>
</dependency>
直接使用他们的ip地址库,搓一个demo试一下。
public static void main(String[] args) throws Exception {
    byte[] buff = ResourceUtil.readBytes("ip2region.xdb");
    Searcher searcher = Searcher.newWithBuffer(buff);
    String region = searcher.search("1.0.32.1");
    System.out.println(region);
}
运行后得到结果
中国|0|广东省|广州市|电信试了几个常用IP后发现数据不是很准确,工具文档上已经有说明:

并且ip2region.xdb这个文件有点大。简单分析了一下:
1、我不需要国外的IP信息。
2、我不需要运营商信息。
3、省市县信息依然是文字,没有快速获取到省市县编码
于是决定自己整理生成一个xdb数据。
原始数据选择了纯真社区版IP库(https://www.cz88.net/)

获得授权后,得到了dat数据。为了查看详细信息,我决定先把这个文件解析出来:
参考文章(https://www.iteye.com/blog/hzy3774-1851364)
#include <stdio.h>

#define DAT_FILE "./qqwry20240731.dat"
#define OUT_FILE "./out.txt"

FILE *out = NULL;

void showIp(unsigned int ip)
{
    char buffer[20] = {0};
    sprintf(buffer, "%u.%u.%u.%u  ", (ip >> 24) & 0xff, (ip >> 16) & 0xff, (ip >> 8) & 0xff, ip & 0xff);
    fputs(buffer, out);
}

void getString(FILE *fp)    //讀取字符串并写入文件,以0为结尾标志
{
    char temp[128] = {0};
    int index = 0;
    while ((temp[index] = fgetc(fp)) != 0)
    {
        index++;
    }
    fputs(temp, out);
}

void getInfo(FILE *fp, int flag)    //获取数据区字符串信息,flag为1时表示已经读了一半字符串
{
    unsigned char mod;
    long int offset = 0;
    long int preOffset = 0;

    mod = fgetc(fp);            //获取模式
    if (mod > 2)             //如果无重定向
    {
        fseek(fp, -1L, SEEK_CUR);   //返回
        getString(fp);          //读取一个字符串
        if (flag == 0)          //如果调用函数时还未读
        {
            getInfo(fp, 1);     //标志置1,递归调用
        }
        return;
    }
    fread(&offset, 3, 1, fp);       //如果有重定向,获取重定向偏移
    if (mod == 1)                   //如果模式一
    {
        fseek(fp, offset, SEEK_SET);    //seek到目标地址
        getInfo(fp, flag);              //递归读
        return;
    }
    preOffset = ftell(fp);          //如果模式二,记住当前偏移
    fseek(fp, offset, SEEK_SET);    //寻目标地址
    getInfo(fp, 1);                 //读一个字符串
    if (flag == 0)                  //如果调用函数时还未读
    {
        fseek(fp, preOffset, SEEK_SET);     //还要回到原来位置
        getInfo(fp, 1);                     //再读一次
    }
}

void parseRecord(FILE *fp, long int recordOffset)
{
    unsigned int endIp = 0;

    fseek(fp, recordOffset, SEEK_SET);  //seek到数据区
    fread(&endIp, 4, 1, fp);        //读取结束IP
    showIp(endIp);                  //显示结束IP
    getInfo(fp, 0);                 //获取信息
    fputs("\n", out);
}

void parseDat(FILE *fp)
{
    long int startIndexOffset = 0;
    long int endIndexOffset = 0;
    long int indexOffset = 0;
    long int recordOffset = 0;
    unsigned int startIp = 0;

    fseek(fp, 0L, SEEK_SET);            //seek文件头
    fread(&startIndexOffset, 4, 1, fp); //读索引开始偏移量
    fread(&endIndexOffset, 4, 1, fp);   //读索引结束偏移量
    indexOffset = startIndexOffset;
    while (indexOffset <= endIndexOffset)    //循环从根据索引读取数据
    {
        fseek(fp, indexOffset, SEEK_SET);   //seek到索引位置
        fread(&startIp, 4, 1, fp);          //读取索引中的开始IP
        fread(&recordOffset, 3, 1, fp);     //读取对应数据区的偏移量
        indexOffset = ftell(fp);            //记住索引的偏移量
        showIp(startIp);                    //显示开始IP
        parseRecord(fp, recordOffset);      //读取数据区
    }
}

int main(void)
{
    FILE *fp = NULL;

    out = fopen(OUT_FILE, "wb");
    fp = fopen(DAT_FILE, "rb");
    if (fp == NULL )
    {
        printf("open file error!\n");
        return 0;
    }
    parseDat(fp);
    fclose(fp);
    return 0;
}
于是得到了一个80+MB的超大文件

分析了一下结构,先对数据进行清理。
首先舍弃掉了国外的数据,然后移除/后面的精确地址,最终保留省市县名称和2位行政编码。如湖南省430000,只存储43
import json,re
# 加载省市县数据
with open("region.json", 'r', encoding='utf-8') as file:
    data = json.load(file)
print("---省市县加载完成---")

with open('ip2region.txt', 'w', encoding='utf-8') as outfile:
    with open('out.txt', 'r') as file:
        line = file.readline()
        while line:
            # 去掉国外的
            if "中国" not in line:
                line = file.readline()
                continue
            line = line.replace("中国–","")
            line = line.split("  ")
            # 解析省市县 移除不必要的数据
            # /后面的是精确地址,舍弃
            area = line[2].split("–")
            containProvince = None
            containCity = None
            containCounty = None
            # 匹配省
            for province in data:
                if re.search(province["short_name"], area[0]) is not None:
                    # 找到了省
                    containProvince = province
                    # 有第二级地区
                    if(len(area)>2):
                        for city in province["children"]:
                            if re.search(city["short_name"], area[1]) is not None:
                                # 找到了省
                                containCity = city
                                if(len(area)>3):
                                    for county in city["children"]:
                                        if re.search(county["short_name"], area[2]) is not None:
                                            # 找到了省
                                            containCounty = county

            if containProvince is None:
                #没有省的数据 跳过
                continue
            # 只保留省市县,其他信息丢弃
            result=line[0]+"|"+line[1]+"|"+containProvince["region_name"]+"|"+str(containProvince["id"])[:2]
            if containCity is not None:
                result = result +"|"+containCity["region_name"]+"|"+str(containCity["id"])[3:4]
            if containCounty is not None:
                result = result +"|"+containCounty["region_name"]+"|"+str(containCounty["id"])[5:6]
            result=result+"\n"
            outfile.write(result)
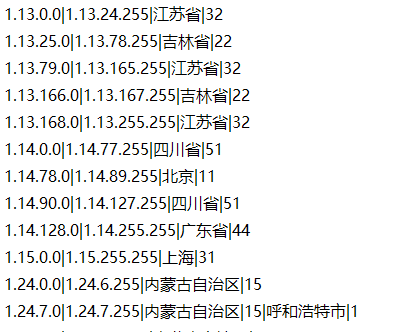
然后就得到了这样的数据,有15W多条。
然后利用ip2region提供的数据生成python实现(https://gitee.com/lionsoul/ip2region/tree/master/maker/python),转成XDB数据。
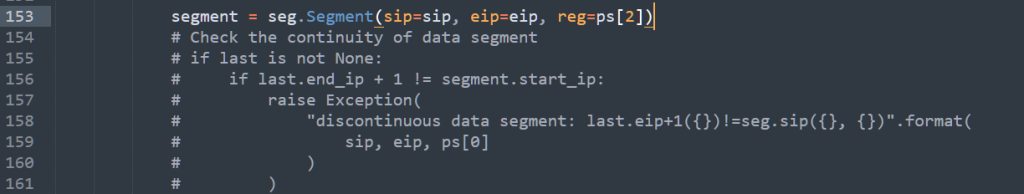
python genxdb.py gen --src=./ip2region.txt --dst=./ip2region.xdb期间报了一个错误,make.py155-161行,上一行的结束IP和下一行的起始IP不连续,直接注释掉这段代码
然后就得到了新的xdb文件,只有2.6MB,小了很多,检查发现,还可以更加精简,由于去掉了详细地址和运营商等信息,很多地址信息是相同且连续的,可以合并:
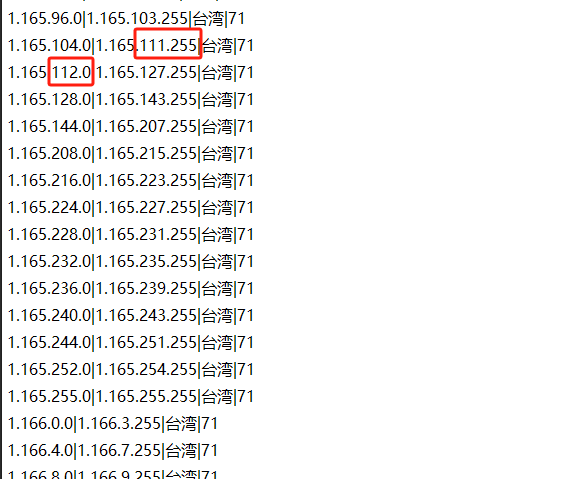
于是我修改了maker.py中的load_segments函数,增加了合并连续IP相同地址的逻辑,合并后,数据减少到6W条,生成的XDB文件仅1MB:
            if last is not None:
                if last.end_ip + 1 == segment.start_ip:
                    if last.region == segment.region:
                        # 移除最后一个元素,修改当前元素的起始IP
                        self.segments.pop()
                        segment.start_ip = last.start_ip
最后,重新编写了解析工具类,就可以自动解析出行政编码了
public static IP2Region getIPAttribution(String ip) {
    IP2Region ipAttribution = new IP2Region();
    ipAttribution.setIp(ip);
    try {

        Searcher searcher = Searcher.newWithBuffer(ResourceUtil.readBytes("META-INF/ip2region.xdb"));

        String region = searcher.search(ip);

        searcher.close();

        String[] result = region.split("\\|");
        if (ObjectUtil.isNotNull(result[0])) {
            ipAttribution.setProvince(result[0]);
            ipAttribution.setProvinceId(StrUtil.padAfter(result[1], 6, "0"));
        }
        if (ObjectUtil.isNotNull(result[2])) {
            ipAttribution.setCity(result[2]);
            ipAttribution.setCityId(StrUtil.padAfter(result[1] + StrUtil.padPre(result[3], 2, "0"), 6, "0"));
        }
        if (ObjectUtil.isNotNull(result[4])) {
            ipAttribution.setCounty(result[4]);
            ipAttribution.setCountyId(result[1] + StrUtil.padPre(result[3], 2, "0") + StrUtil.padPre(result[5], 2, "0"));
        }
    } catch (Exception ignore) {
    }
    return ipAttribution;
}



https://zhuanlan.zhihu.com/p/1916893794655254095 谢谢参考你这个转化成功,但是你这个c++有问题不能转化完,已经做了调整
qqwry20240731.dat 这个能不能共享, xdb 原先的移动ip的数据库太少了
有生成好的吗老哥
有呀
求一份代码
完整代码已经在文章中了噢
博主求分享文件